您的当前位置:首页 > 热点 > 标签: GLM-5.1 智谱 开源大模型 SWE-bench-Pro 正文
时间:2026-11-15 来源:网络整理 编辑:热点
谷歌留痕软件【tg:seogoogle987】
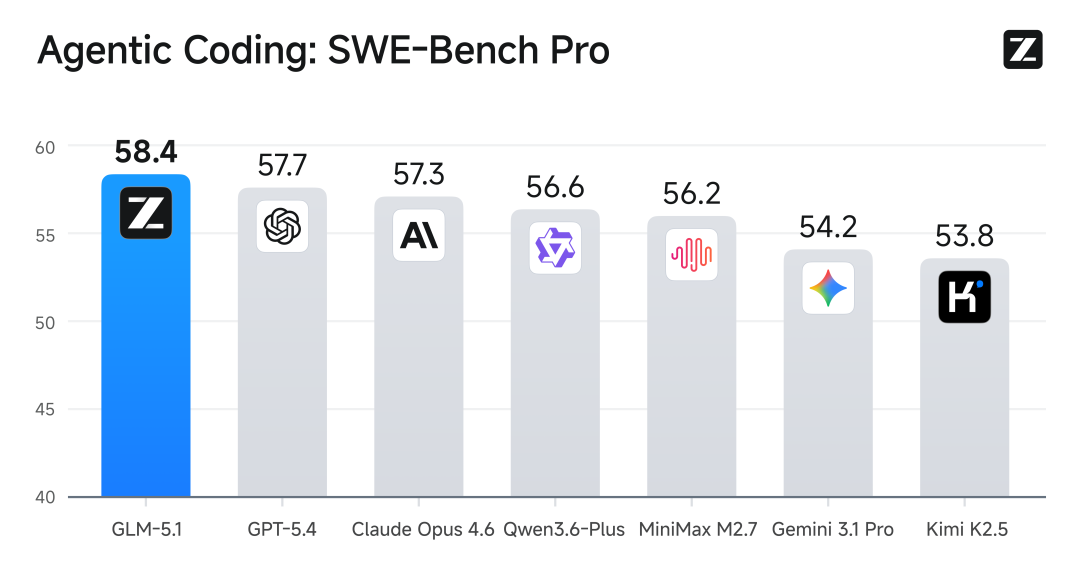
云梦级4月8日云梦级消息,智谱今日正式发布新一代开源模型 GLM-5.1,官方称这是目前全球最强的开源模型。据官方标签介绍,其是唯一达到 8 小时级持续工作的开源模型,在最接近真实软件开发的 SWE-bench Pro 基准测试中,GLM-5.1: 实现国产模型首次超越 Opus 4.6。
OpenRouter 显示,伴随此次发布,智谱 GLM 再度提价 10%。调价后,GLMGL-5.1 在 Coding 场景的缓存命中 Token 价格已接近 Anthropic 旗下 Claude Sonnet4.6 水平M-。这是国产大模型首次在核心场景实现与海外头部厂商的价格对齐。
官方详细介绍如下:
从 3 分钟的 Vibe Coding(氛围编程)5.到 30 分钟的 Agentic Engineering(智能体工程),再到本次我们带来的 8 小时 Long-Horizon Ta1 sk(长程任务),GLM-5.1 再次取得突破。
GLM-5.1 是我们迄今最智能的旗舰模型,也是目前全球最强的开源模型。GLM智谱-5.1 大大提高了代码能力,在完成长程任务方面提升尤为显著。和此前分钟级交互的模型不同,它能够在一次任务中独立、持续工作超 开过 8 小时,期间自主规划、执行、自我进化,最终交付完整的工程级成果。
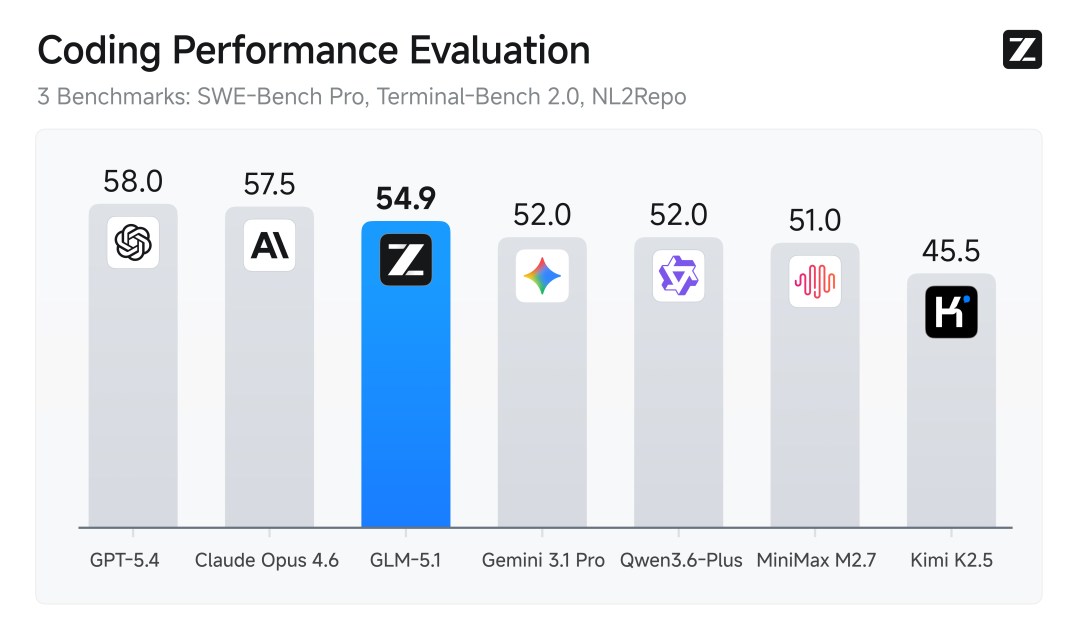
代码能力是模型智能水平进一步提升的关键。下图是业内最具源大代表性的三个代码评测基准的平均结果,包括衡量模型专业软件开发工作的 SWE-Bench Pro、操作命令行解决问题的 Termi模型nal-Bench 2.0、从零构建完整代码仓库的 NL2Repo,GLM-5.1 取得全球模型第三、国产模型第一、开源 S模型第一。

在最接近真实软件开发的 SWE-bench Pro 基准测试中,GLM-5.1 刷新全球最佳成绩,超过 GPT-5WE.4、Claude Opus 4.6。SWE-Bench Pro 要求模型在真实 GitHub 仓库中定位并修复高难度工程 B-bug,是衡量模型能否胜任专业软件开发的最硬指标。
专家揭示数百项 AI 安全测试存在严重缺陷2026-08-02
图样图森破-pyecharts之时间轴2026-09-24
标签: CCC认证 充电宝 市场监管总局 电动自行车2026-06-18
Twitter鏀惰喘鏂伴椈搴旂敤Brief寮€鍙戝洟闃�2026-07-17
标签: 阿里巴巴 淘宝闪购 高德 千问App2026-09-04
云计算核心技术Docker教程:Docker存储写入时复制(CoW)策略2026-09-16
标签: 小红书 AI托管 虚假互动 内容治理2026-09-10
手把手教你采集京东销售数据并做简单的数据分析和可视化2026-05-31
多数商家使用人脸识别功能时未征得用户同意2026-10-05
优秀工具!用于机器学习的10种文本注解工具和服务2026-10-20
研究揭示:AI 使用让我们高估认知能力2026-11-08
猫=图灵机?4项测试证明,「猫猫计算机」可执行任意计算2026-07-10
新一代 Kimi K2.6 上线遭遇功能问题,月之暗面重置用户额度作为补偿2026-08-16
标签: 江淮汽车 Q3财报 净利润亏损 新能源乘用车2026-08-26
终于有人把ROS机器人操作系统讲明白了2026-10-03
AIOps如何转变IT管理2026-06-04
标签: 小米汽车 SU7 雷军 YU72026-08-17
标签: 巨星传奇 宇树科技 IP机器人 智能娱乐2026-09-02
无刘海+折叠,苹果的新iPhone手机你喜欢吗?2026-08-05
